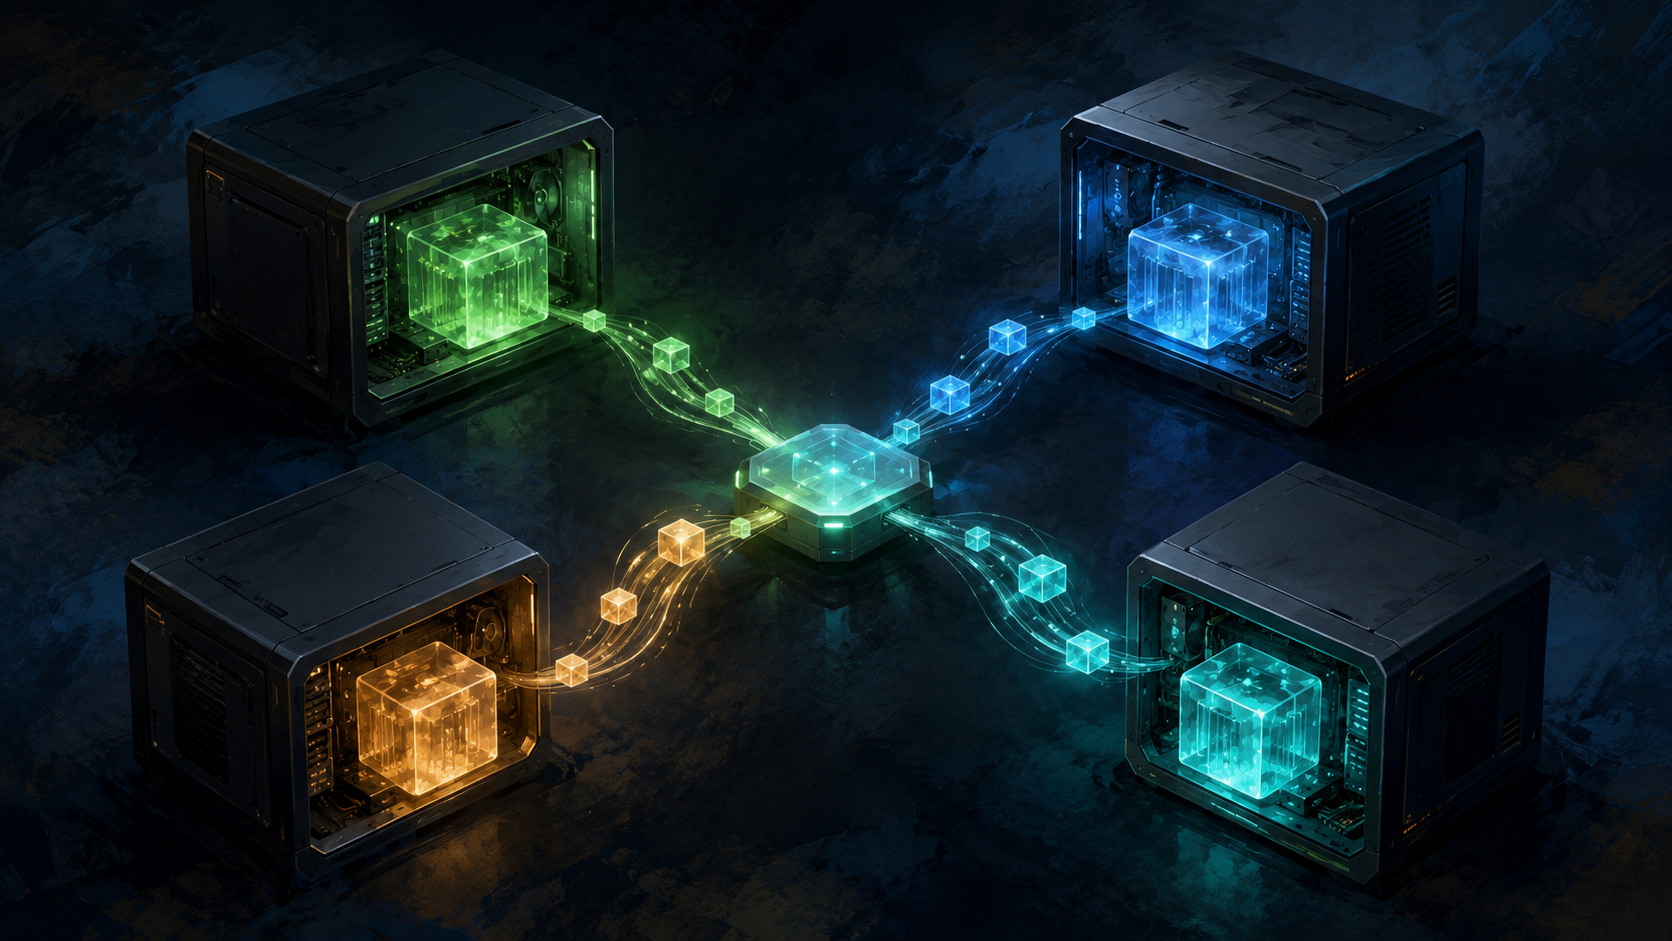
NVIDIA PAIRが増やすのは「1つのモデルで使えるVRAM」ではなく、「同時に処理できる独立リクエストの数」だ。
NVIDIAは米国時間2026年9月3日、家庭や小規模オフィスにある複数のPCをローカルAI推論用のクラスターとして使う「NVIDIA Personal AI Router(PAIR)」を発表した。Windows、Linux、macOSに対応する無料のオープンソースソフトウェアで、ベータ版が公開されている。
名前に「Router」とある通り、PAIRの本質は推論エンジンではなく交通整理役だ。OllamaやLM Studioへ届いた仕事を監視し、必要なモデルを持ち、比較的空いているPCへ1件ずつ振り分ける。複数のAIエージェントを並行して走らせる場面では待ち時間を短縮できる一方、24GBのGPUを2台つないでも48GBの仮想GPUにはならない。
本稿では、NVIDIAの発表文だけでなく、PAIRのアーキテクチャ文書、既知の問題、セキュリティ文書、ソースコード公開ページまで確認した。公式デモの速度向上率、70Bモデルに必要なメモリ、モデル複製に伴うストレージ、LAN転送量、電気代を同じ前提で計算し、競合ソフトとも用途別に比べる。
| 確認項目 | NVIDIA PAIRの実像 |
|---|---|
| できること | 独立した推論リクエストを、同一LAN上の空いている対応PCへ振り分ける |
| できないこと | 複数PCのGPUメモリを1つに見せる、1件の推論を複数ノードへ分割する |
| 対応エンジン | Ollama、LM Studio |
| 主な対応機器 | GeForce RTX 20シリーズ以降、RTX PRO(Turing以降)、DGX Spark、Apple M4以降 |
| 対応OS | Windows 11、Linux、macOS。異なるOSの混在も可能 |
| 公開形態 | ベータ版、Apache License 2.0。執筆時点のGitHub最新版はv0.1.1 |
NVIDIA PAIRは「空いているPCへ仕事を回す受付係」
PAIRをレストランに例えるなら、厨房を巨大化する装置ではなく、注文ごとに空いている厨房を選ぶ案内係である。
利用者のアプリは、従来通りローカルのOllama互換またはOpenAI互換APIへリクエストを送る。PAIRは同一LAN上のノードを見つけ、各ノードについて「オンラインか」「推論エンジンが動いているか」「指定されたモデルがあるか」「実行中のジョブが何件か」「GPUが混雑しているか」を追跡する。そのうえで候補を順位付けし、1件のリクエストを1台に渡す。
選ばれた後、そのリクエストは終了まで同じノードが担当する。生成途中で別のPCへ移したり、1トークンの計算を複数PCに割ったりはしない。実際にモデルを実行するのもPAIRではなく、選択先のOllamaまたはLM Studioだ。既存アプリ側の大きな改修を避けられる半面、推論速度や対応モデル、メモリ要件は各エンジンと各PCに左右される。
クラスターには固定の親機がない。各ノードは対等で、リクエストを受け付ける側にも実行する側にもなれる。GPUを持たないノートPCを入口にして、別室のRTXデスクトップへ処理だけを送る構成も可能だ。
24GB+24GBでも48GBにはならない――VRAM合算の誤解
PAIRでは1件のリクエストを1台が処理するため、使えるモデルの上限は「VRAMの合計」ではなく「そのモデルを持つ1ノードの実行可能メモリ」で決まる。
たとえばVRAM 24GBのGPUを積んだPCが2台あっても、PAIRから見れば24GBの厨房が2つあるだけだ。別々の質問を2件同時に処理しやすくはなるが、1件の質問に48GBを使えるわけではない。
70B(700億パラメーター)モデルを4bit量子化した場合、重みだけの理論最小値は次の通りだ。
700億パラメーター × 4bit ÷ 8 = 350億byte ≒ 35GB
実際には量子化用のメタデータ、KVキャッシュ、実行時バッファも要る。したがって「24GB GPUを2台、合計48GBだから35GBのモデルが載る」という計算はPAIRには通用しない。各PCでCPUメモリへ一部を逃がせる場合はあるが、それは各推論エンジンの機能であり、GPUだけで処理する場合より遅くなりやすい。
| 構成例 | 物理メモリの合計 | PAIRで1件に使える上限の考え方 | 同時処理 |
|---|---|---|---|
| 24GB GPU搭載PC × 1台 | 24GB | その1台に収まるモデル | 基本は1系統 |
| 24GB GPU搭載PC × 2台 | 48GB | 依然として1台あたり24GBが基準 | 独立した2件を並行しやすい |
| 24GB+32GBの2台 | 56GB | 大型モデルは32GB側で実行できる範囲まで | 小型モデルなら両方を活用可能 |
| 単一PC内で複数GPUをモデル分割 | 構成次第 | エンジン側が対応すれば分割可能 | PAIRとは別レイヤーの機能 |
NVIDIA自身もFAQと技術ブログで、ノードは別々のシステムのままであり、PAIRは仮想GPUを作らず、モデルを分割しないと明記している。「AIクラスター」という言葉から、データセンターの高速GPUファブリックと同じ動きを想像しないほうがよい。
公式デモは18分から8分48秒へ――独自計算では2.05倍
NVIDIAのデモで短くなったのは1回の生成速度ではなく、5つのサブエージェントを含む処理全体の完了時間である。
NVIDIAの技術ブログによると、Hermes DesktopからQwen 3.6 35B A3Bを使う5サブエージェントのワークフローを実行したところ、単独のRTX SparkノートPCでは平均18分、同ノートPC、DGX Spark、GeForce RTX 5090搭載機の3台構成では平均8分48秒だった。
| 指標 | 計算 | 結果 |
|---|---|---|
| 短縮時間 | 18分00秒 − 8分48秒 | 9分12秒 |
| 所要時間の削減率 | (1,080秒 − 528秒) ÷ 1,080秒 | 51.1% |
| 高速化率 | 1,080秒 ÷ 528秒 | 2.05倍 |
| 3台に対する単純な並列効率 | 2.05 ÷ 3 | 68.2% |
| 完全に3倍なら | 18分 ÷ 3 | 6分00秒 |
3台が異種構成で、サブタスクの重さも同じとは限らないため、68.2%は製品間比較に使える正式な効率値ではない。それでも、3台に増やしても3倍にはならない理由は見える。分割できない処理、タスク間の依存、モデルの起動待ち、遅いノード、スケジューラーの判断が残るからだ。
参考に、処理の80%だけを3台へ完全分散できると仮定すると、アムダールの法則による上限は 1 ÷ (0.2 + 0.8 ÷ 3) = 2.14倍 になる。これは説明用の試算であり、公式デモの並列化率が80%だったことを意味しない。PAIRの価値を測るなら、1トークン目までの速さより、複数の仕事をすべて終えるまでの時間を見るべきだ。
速くなる処理、ほとんど変わらない処理
PAIRの効果を分ける境界線は、仕事を「互いに待たない複数リクエスト」へ分解できるかどうかにある。
| 期待しやすい用途 | 理由 | 効果が小さい用途 | 理由 |
|---|---|---|---|
| 複数サブエージェントの並行調査 | 独立した問い合わせを別ノードへ送れる | 1本だけの長文生成 | 1件は最後まで1ノードが担当する |
| 大量文書の個別要約・分類 | 文書単位で分けやすい | 単一モデルの1件あたり生成速度向上 | モデルも計算もノード間で分割しない |
| 家族・チームの同時利用 | 待ち行列を複数機へ散らせる | どのPCにも収まらない大型モデル | 合計VRAMは利用できない |
| 複数のローカルAIセッション | セッションごとに別ノードを選べる | モデルが1台にしかない構成 | そのモデルの候補は1台だけになる |
「PCを足せば、今見ているチャットの返答がそのまま2倍速くなる」と考えると期待外れになりやすい。対して、コーディングエージェントを3本、調査エージェントを2本、家族のチャットを1本といった具合に、同時発生する仕事が多いほど効きやすい。PAIRはレイテンシー改善装置というより、家庭内推論のスループット改善装置に近い。
4台あっても、同じモデルを使えるのは1台だけかもしれない
クラスターの実効台数はPCの総数ではなく、「オンライン・エンジン稼働・指定モデルあり」の3条件を同時に満たす台数で数えるべきだ。
本稿では、あるモデルMに対する実効ノード数を次のように定義する。
N_eff(M) = 「オンライン」かつ「エンジン稼働中」かつ「モデルMを正確な名前で保有」のノード数
PCが4台あっても、Mを持つのが2台、そのうち1台のエンジンが停止中なら N_eff(M)=1 だ。この状態ではMの負荷分散は起きない。別モデルを各PCへ置く構成はモデルごとの役割分担には向くが、同じモデルへの同時アクセスをさばくには各ノードへ同じモデルを複製する必要がある。
ここで見落としやすいのが保存容量と初回準備だ。重みが約35GBのモデルを3台へ置けば、単純合計は約105GBになる。量子化形式や補助ファイルを含めれば、さらに増える場合がある。3台で1本を共有するのではなく、3本の独立コピーを用意するからだ。
もう1つはコールドスタートである。PAIRの公開アーキテクチャによると、現行スケジューラーはモデルがすでにメモリへ載っているかを考慮しない。35GBを毎秒3GBで読めるSSDから読むだけでも、規格上の単純計算で最低約11.7秒かかる。実際にはGPUへの転送や初期化も加わる。暖まっているPCがあるのに、空いているがモデル未ロードのPCが選ばれ、最初の返答が遅くなる可能性は残る。
PAIRのスケジューラーは賢いが、現行版は「仕事の重さ」を見ない
現行スケジューラーは3トークンの短い依頼も10万トークン級の依頼も、待ち行列上は同じ「1ジョブ」として数える。
PAIRは実行中・待機中のジョブ数に、GPU使用率から作った粗い混雑度を加えて候補を並べる。公開文書ではGPU使用率40%、70%、85%を境に、混雑度を0~3の4段階へ丸める。情報が欠けている、無効、または10秒以上古い場合は中間の1として扱う。
一方、GPUの型番、利用可能なVRAM、実測レイテンシー、モデルがロード済みか、入力の長さや予想計算量は順位付けに入らない。高速なRTX 5090と遅いノードがどちらも空いていれば、重い仕事が遅い側へ送られることもある。複数GPUを積んだ1台についても、最も忙しいGPUの値でノード全体を代表するため、別GPUの余力を細かく生かせない場合がある。
また、各ノードがそれぞれ判断する分散型なので、別々の入口から同時に届いた依頼が、瞬間的に同じ「空きノード」を選ぶこともあり得る。これは中央サーバーを置かず、親機が落ちても構成を保ちやすくする設計との交換条件だ。ベータ版では、台数を増やすだけでなく「どの仕事がどこへ流れたか」をJobs画面で確かめる運用が欠かせない。
家庭用LANで十分なのか――10万トークンでも文字なら約0.4MB
PAIRはモデルの重みやGPU間の中間計算を毎トークン交換しないため、一般的な文字リクエストではLAN帯域より各ノードの推論性能が先に制約になりやすい。
英語中心のテキストを「1トークンあたり4バイト相当」と仮定すると、10万トークンの入力は約0.4MBだ。JSONヘッダーやTLS、往復遅延を無視した理論値では、1Gbps LANの転送時間は約3.2ミリ秒、10Gbpsなら約0.32ミリ秒になる。10件同時でも本文は約4MBで、1Gbpsの規格値なら約32ミリ秒分だ。
これは文字だけの概算であり、画像、音声、base64化したデータ、巨大な検索結果を含めれば転送量は増える。Wi-Fiの混雑やルーターの処理能力も無視できない。それでも、モデルをノード間で分割する方式とは通信の性質が違う。
規格上、10GbEは毎秒1.25GB、PCI Express 4.0 x16は片方向で毎秒約31.5GBと、単純比較で約25倍の差がある。モデル分割方式は層間のデータを繰り返し渡すため、家庭内ネットワークの遅さが効きやすい。PAIRが1件丸ごとを1台へ渡す設計を選んだのは、既存LANで導入しやすくする現実的な判断でもある。
セキュリティはmTLS対応。ただし「ローカル=自動的に安全」ではない
プロンプトを運ぶクラスター通信はmTLSで保護されるが、PAIRをインターネットへ公開せず、信頼できる家庭内・社内LANに限定する前提は変わらない。
ノードの追加には6桁のPINを使い、その後のクラスター通信は相互TLS(mTLS)で暗号化・認証される。中央クラウドへ推論を送らずに済むことは、PAIRの大きな利点だ。
ただしNVIDIAのセキュリティ文書は、6桁PINを長期的な秘密鍵ではなく初回接続用と位置付けている。アーキテクチャ文書には、ホスト名、ハードウェア情報、GPU使用率など一部のテレメトリーが、同一サブネット上から認証なしの平文HTTPで取得できる設計も記載されている。これはプロンプト本文が平文で流れるという意味ではないが、共有Wi-Fiや来客用ネットワークで無警戒に使う理由にもならない。
さらに「ローカル推論」と「通信が一切外へ出ない」は同義ではない。OllamaやLM Studio、モデル配布元、更新機能、接続するAIアプリが外部通信を行う可能性は別途確認が必要だ。ポート転送や公開リバースプロキシは避け、IoT機器や来客端末とはネットワークを分け、OSのファイアウォールを有効にするのが妥当である。
exo、llama.cpp RPC、vLLMとの違い――競合というより目的が別
「複数PCで1つの大型モデルを動かしたい」ならPAIRではなくモデル分割型、「同じモデルへの多数の依頼をさばきたい」ならPAIRが候補になる。
| 方式・製品 | 主目的 | 1モデルを複数機へ分割 | VRAM・メモリの扱い | 導入難度と向く利用者 |
|---|---|---|---|---|
| NVIDIA PAIR | 独立リクエストの自動振り分け | しない | ノードごとに独立 | 比較的低い。複数PCを持つ個人、家庭、小規模チーム |
| exo | 家庭内機器を使った分散推論 | する | モデルの重みを機器間へ分割できる | PAIRより構成要因が多い。特にApple Silicon中心の実験環境 |
| llama.cpp RPC | llama.cppの計算・メモリを遠隔デバイスへ分散 | する | 重みとKVキャッシュをローカル・遠隔へ割り当てる | 手動設定が多い。公式文書も実証段階で脆弱と注意しており、閉じた信頼ネットワーク向け |
| vLLM | サーバー/データセンター級の高スループット推論 | する | Tensor Parallel、Pipeline Parallel、Data Parallelを選べる | 高い。コンテナ、Ray、同一実行環境などを管理できる組織向け |
exoやllama.cpp RPCが実現するのも「物理VRAMが1枚になる」ことではなく、モデルを複数メモリへ分けて実行する仕組みだ。ネットワークをまたぐたびに同期や転送の負担が生じる。vLLMは本格的な分散推論とデータ並列を備えるが、家庭内のWindows PC、Mac、DGX SparkをGUIでつなぐPAIRとは運用の重さが違う。
PAIRはモデル選択ルーターでもない。依頼側が「どのモデルを使うか」を指定し、PAIRはその正確なモデル名を持つノードから実行先を選ぶ。質問内容に応じて高性能モデルと軽量モデルを自動で使い分ける機能とは区別したい。
過去の分散コンピューティングと同じ強み、異なる時間感覚
PAIRの発想は、SETI@homeやFolding@homeが証明した「独立した小さな仕事は、多数のPCへ配れば伸びる」という原則を、家庭内AIへ持ち込んだものだ。
SETI@homeは1999年に始まり、電波望遠鏡のデータを小さなワークユニットへ分け、世界中の家庭・職場PCへ配った。Folding@homeも2000年に開始し、分子動力学の計算を参加者の遊休PCへ分散した。新型コロナウイルス研究への参加が急増した2020年には、2.43 exaFLOPS相当へ達したと公式サイトが説明している。
成功の条件は、仕事同士の依存が小さく、結果を後でまとめられることだった。PAIRも同じく「ばらばらに処理できる仕事」に強い。ただし従来のボランティア計算は数時間後に結果が返ればよかったのに対し、対話型AIは数秒の遅れが体感に響く。だからPAIRでは、モデルの配置、起動済みかどうか、ノード性能の差が従来以上に重要になる。
言い換えれば、PAIRは新しい物理法則を持ち込んだのではない。分散計算で古くから効く「bag of tasks(独立タスクの束)」を、OllamaやLM Studioの既存APIを壊さずに日常のAIアプリへ接続した点が新しい。
「無料のAI計算資源」への反証――電気代と熱は増える
すでにPCを所有していても、遊休GPUを動かす電力、排熱、モデルの複製、保守の手間まで無料になるわけではない。
NVIDIAは家庭内の未使用計算能力を生かせる点を訴える。クラウドAPIの従量課金を抑え、機密データをLAN内で処理できる可能性は確かにある。反対に、電源が切れていたPCをPAIRのためだけに起動するなら、比較対象は「埋没した計算資源」ではなく追加運転費だ。
独自試算として、追加で動かす2台がそれぞれ平均150~300Wを消費し、1日4時間、月30日、電気料金を1kWh当たり35円と仮定する。
0.30~0.60kW × 4時間 × 30日 × 35円 = 月1,260~2,520円
これはPAIRの実測値でも、日本全国の平均料金でもない。PC構成、モデル、電源効率、地域、契約で大きく変わる。夏場は同じ電力が室内の熱となり、冷房負荷も増える。クラウドとの比較では、GPU時間の料金だけでなく、ローカル側の電力、設備費、待ち時間、データ管理の価値をそろえて見る必要がある。
| よくある主張 | 反証・条件 |
|---|---|
| PCが増えれば台数比例で速くなる | 直列部分、性能差、モデル未配置、コールドスタートがあるため比例しない |
| 家のVRAMを全部使える | 1リクエストは1ノード。合算VRAMでは大型モデルを動かせない |
| ローカルだから情報は絶対に外へ出ない | PAIRの経路はローカルでも、エンジンやAIアプリ、更新機能は別に監査が必要 |
| 手持ちPCなので追加費用はゼロ | 電気代、排熱、ストレージ、モデル取得時間、運用工数が生じる |
読者への影響――買い足す前に「実効ノード数」を測る
PAIRのためにGPUを買うより先に、手持ち機器だけで同じモデルを2台へ置き、同時リクエスト時の総完了時間が短くなるかを試すのが合理的だ。
恩恵を受けやすいのは、すでにRTX PCやM4以降のMacを複数持ち、コーディング、調査、要約などのAIエージェントを同時に走らせる人だ。家族や小規模チームで同じローカルモデルを共有し、1台の待ち行列が詰まっている場合にも合う。クラウドへ渡したくない文書を、信頼できるLAN内で扱いたい利用者にも選択肢になる。
一方、目的が「手持ち2台のVRAMを足して、1台では入らない70Bモデルを動かす」ならPAIRは答えではない。exo、llama.cpp RPC、vLLMの分散方式、単一PC内のマルチGPU対応、または大容量メモリ機を検討することになる。1人が1本のチャットしか使わない場合も、改善幅は限られる。
NVIDIAが示す「2台以上のPCがある世帯」という市場規模だけで、使える世帯数は決まらない。実際の対象は、おおむね次の掛け算になる。
複数PC世帯 × 対応ハード比率 × 同時に電源が入る比率 × 同一モデルを実行できる比率 × 並列リクエストがある比率
この5条件を通るほど、見かけの対象市場は小さくなる。ただし条件を満たす家庭では、眠っていた2台目を実用的な待ち行列として使える。PAIRの狙いは全家庭のPCをスーパーコンピューターに変えることではなく、すでに計算資源が散在する家庭の「渋滞」を減らすことだ。
導入前に確認したい5項目
動作確認では「ノードが見える」だけで終わらせず、同じモデルが複数ノードに表示され、実際のジョブが別々のPCへ流れるところまで確かめたい。
| 項目 | 確認内容 | 注意点・確認方法 |
|---|---|---|
| 同じモデル名をそろえる | PAIRは正確なモデル名で候補を絞る | 同等モデルでもタグや名称が違うと、同じ候補群にならない |
| ポート競合を確認する | Ollamaは通常11434番、LM Studioは1234番をローカル入口に使う | 既存エンジンが先にポートを占有していると、リクエストがPAIRを通らない場合がある |
| ファイアウォールを調整する | ノード間では14318~14323番、探索ではmDNSのUDP 5353番などを使う | 必要なLAN内通信だけを許可する |
| Jobs画面で配送先を見る | 2件以上のリクエストを同時に送り、別ノードへ振り分けられるか確認する | 配送先だけでなく、待ち時間が実際に短くなったかも記録する |
| 停止時の復旧を試す | ノードの離脱には追従する | 現行の既知の問題では、実行サービスが固まった状態を自動検知できない場合があるため、あらかじめ再起動手順を決めておく |
ベータ版である以上、まずは機密性の低いデータと小さな構成で検証したい。比較時は1件の応答速度だけでなく、同時に投げた5件または10件がすべて終わるまでの時間、消費電力、失敗件数を記録すると、PAIRが自分の用途に合うか判断しやすい。
結論:PAIRは「大きな1台」ではなく「混まない複数台」を作る
NVIDIA PAIRはVRAM不足を解決するソフトではないが、複数のAIエージェントが1台のGPU前で行列する問題には、導入しやすい答えを示した。
OllamaやLM Studioの入口を変えず、Windows、Linux、macOSの混在環境へ仕事を自動配送する設計は実用的だ。公式デモも、並列化できる仕事なら総完了時間を半分近くへ縮められる可能性を示している。
評価の軸を間違えてはいけない。見るべき数字は総VRAMではなく、モデルごとの N_eff、同時ジョブの総完了時間、複製ストレージ、電力だ。大型モデル1本を動かしたい人はモデル分割型を、同時に多数の依頼を処理したい人はPAIRを選ぶ。この線引きが、発表の「AIクラスター」という大きな言葉を、購入判断に使える情報へ変える。
一次情報・比較資料
仕様や制限はベータ期間中に変わり得るため、導入時にはNVIDIA公式ページとGitHubの最新版を再確認してほしい。
コメントを送信